I'm available for business trips to other cities for projects lasting a month or longer.
Профиль клиента
Компания Li Auto была основана в 2015 году. Она стремится создавать максимально безопасные, комфортные и удобные автомобили и сервисы для всей семьи.
В современную эпоху, основанную на данных, эффективная аналитическая система имеет решающее значение для бизнеса. Будучи ведущей компанией в сфере интеллектуальных электромобилей, Li Auto сталкивается с задачей обработки огромных объёмов данных. В этой статье рассматривается трансформация OLAP-системы Li Auto от архитектуры shared-nothing к shared-data. Также обсуждаются проблемы, возникшие в ходе этого процесса, и то, как разделение архитектуры хранения и вычислений помогло решить эти проблемы.
В современную эпоху, основанную на данных, эффективная аналитическая система имеет решающее значение для бизнеса. Будучи ведущей компанией в сфере интеллектуальных электромобилей, Li Auto сталкивается с задачей обработки огромных объёмов данных. В этой статье рассматривается трансформация OLAP-системы Li Auto от архитектуры shared-nothing к shared-data. Также обсуждаются проблемы, возникшие в ходе этого процесса, и то, как разделение архитектуры хранения и вычислений помогло решить эти проблемы.
Эволюция OLAP-платформы Li Auto
OLAP-платформа Li Auto значительно выросла: более 12 кластеров, 13 тыс. процессорных ядер, обработка более 10 млн запросов в день и управление примерно 300 Тб данных. Система обрабатывает миллиарды точек данных ежедневно, что отражает впечатляющий рост бизнеса компании.
Эволюция OLAP-системы Li Auto отражает рост и проблемы платформы аналитики данных предприятия. Её можно разделить на три ключевых этапа.
Этап 1 (2022): Унификация платформы
В начале 2022 года Li Auto столкнулась с проблемой использования нескольких OLAP-систем, включая Impala, StarRocks и TiDB, для поддержки различных OLAP-сценариев. Такая мультиконфигурация принесла несколько проблем: высокие затраты на ресурсы, сложное обслуживание и плохое взаимодействие с пользователем.
В ответ команда решила унифицировать OLAP-платформу, выбрав StarRocks для обработки как платформу для аналитики Data Lakehouse, так и задач OLAP. Это решение значительно упростило технологический стек и заложило основу для будущего развития.
Этап 2 (2023): Повышение стабильности и удобства использования
После унификации движка база пользователей расширилась, и начали появляться новые проблемы. Поскольку система работала на выделенных серверах без чётких руководств или ограничений, проблемы со стабильностью системы стали частыми.
Для решения этих проблем команда создала комплексную систему обеспечения стабильности, включающую механизмы мониторинга, проверки и оповещения. Они также разработали стандарты работы пользователей и стандартные операционные процедуры (SOP), а также реализовали стратегии изоляции ресурсов. Кроме того, команда улучшила управление метаданными и возможности импорта/экспорта данных, значительно повысив удобство использования системы.
Этап 3 (2024): Переход к облачной архитектуре
Несмотря на значительный прогресс, команда осознала, что shared-nothing всё ещё сталкивается с присущими проблемами, такими как проблемы изоляции, сложность масштабирования и высокие затраты. В 2024 году Li Auto решила перейти к облачной архитектуре. Они выбрали StarRocks в качестве основной технологии и использовали его возможности множественных хранилищ данных, shared-data и Kubernetes (K8s) для реструктуризации всей OLAP-платформы, открыв новую главу в своей системе аналитики данных.
Позиционирование платформы: унифицированный механизм запросов и аналитики для сценариев больших данных
После прохождения нескольких этапов разработки Li Auto позиционировала свою платформу данных как унифицированный механизм запросов и аналитики для всей корпоративной экосистемы больших данных. На основе StarRocks они создали унифицированный сервис запросов DQS, который предоставляет основные функции, такие как аутентификация, маршрутизация, архитектурное разделение (decoupling) и ограничение скорости, формируя единую точку выхода для их платформы больших данных.
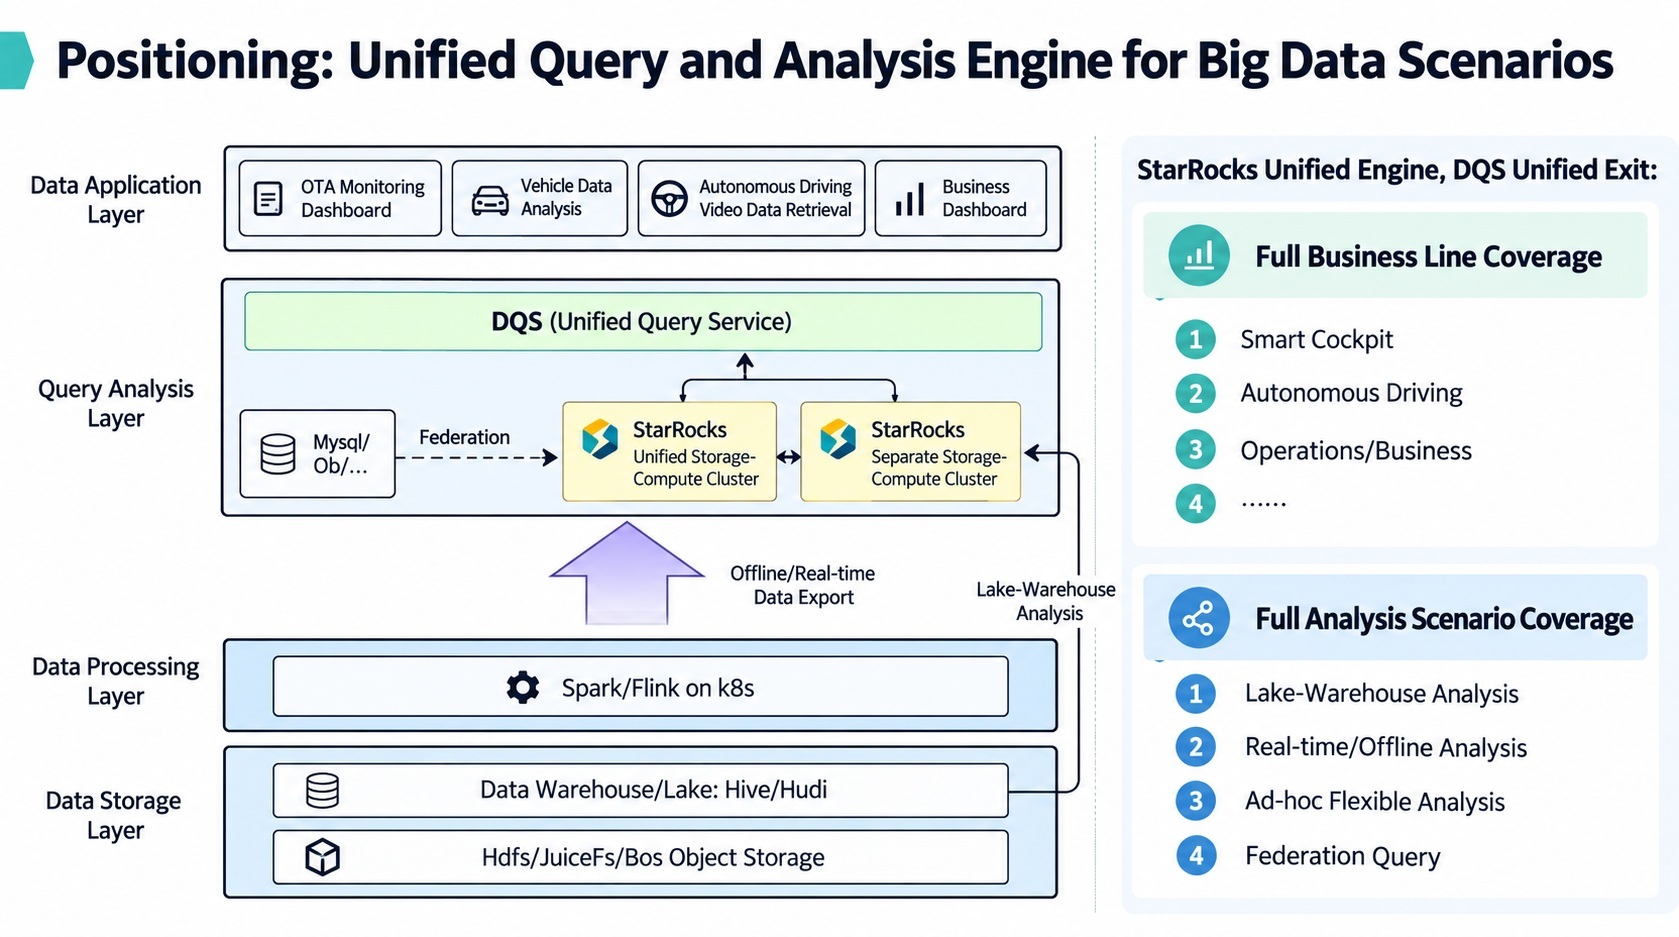
Такая архитектурная разработка не только оптимизировала технологию, но, что более важно, удовлетворила разнообразные потребности бизнеса. От умной приборной панели и технологий машинного обучения до бизнес-анализа предприятия, от аналитических платформ Data Lakehouse, анализа в реальном времени и в офлайн до специальных запросов и федеративных запросов – StarRocks полностью поддержал все бизнес-сценарии и аналитические требования Li Auto, став основным механизмом для принятия решений компанией на основе данных.
Основные проблемы архитектуры shared-nothing
По мере расширения масштабов бизнеса и углубления аналитических требований, ограничения архитектуры shared-nothing становились всё более очевидными. Команда Li Auto столкнулась с тремя ключевыми проблемами на практике.
Проблема 1: Сложность изоляции и обеспечения стабильности в рамках одного кластера
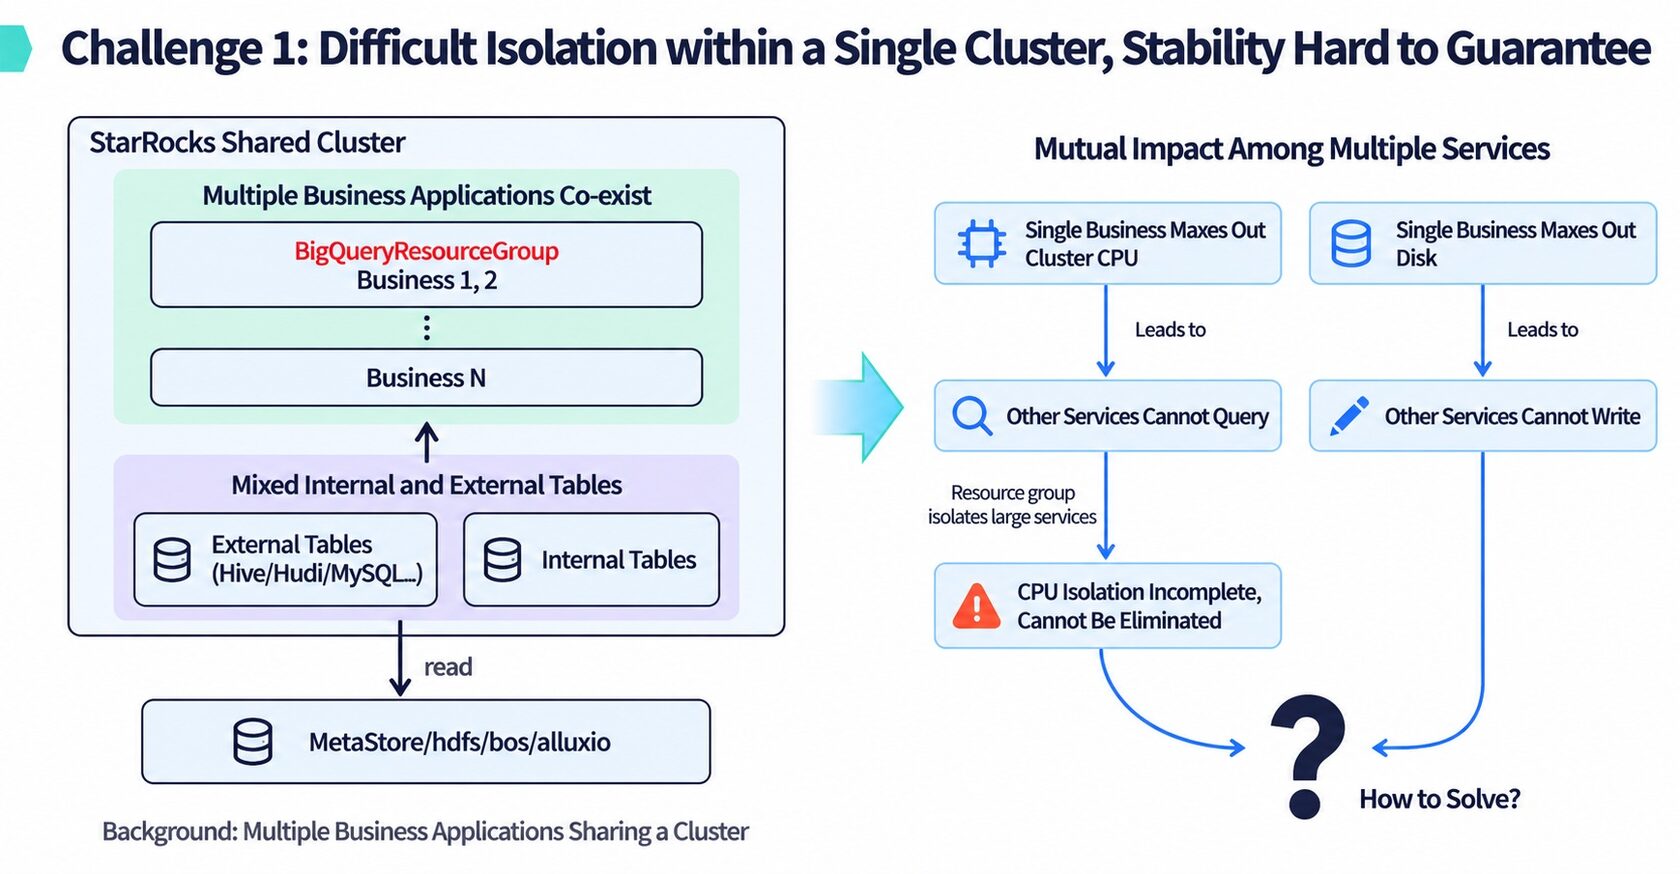
При архитектуре shared-nothing несколько бизнес-функций использовали единый кластер, что часто приводило к взаимным помехам:
«Мы однажды столкнулись с внезапным ростом трафика от одного бизнес-подразделения, которое использовало все ресурсы CPU кластера, из-за чего запросы других бизнес-подразделений встали в очередь и не получали ответов в разумное время».
Хотя команда пыталась использовать Resource Group для достижения изоляции, эффект в отношении изоляции CPU-ресурсов был далёк от идеального.
Кроме того, совместное существование внутренних и внешних таблиц также создавало риски для стабильности. Внешние таблицы зависят от множества внешних компонентов (таких как HiveMetaStore, Alluxio и др.), и нестабильность этих компонентов могла привести к сбою всего кластера.
Проблема 2: Отсутствие гибкости в расширении конфигурации и высокие затраты
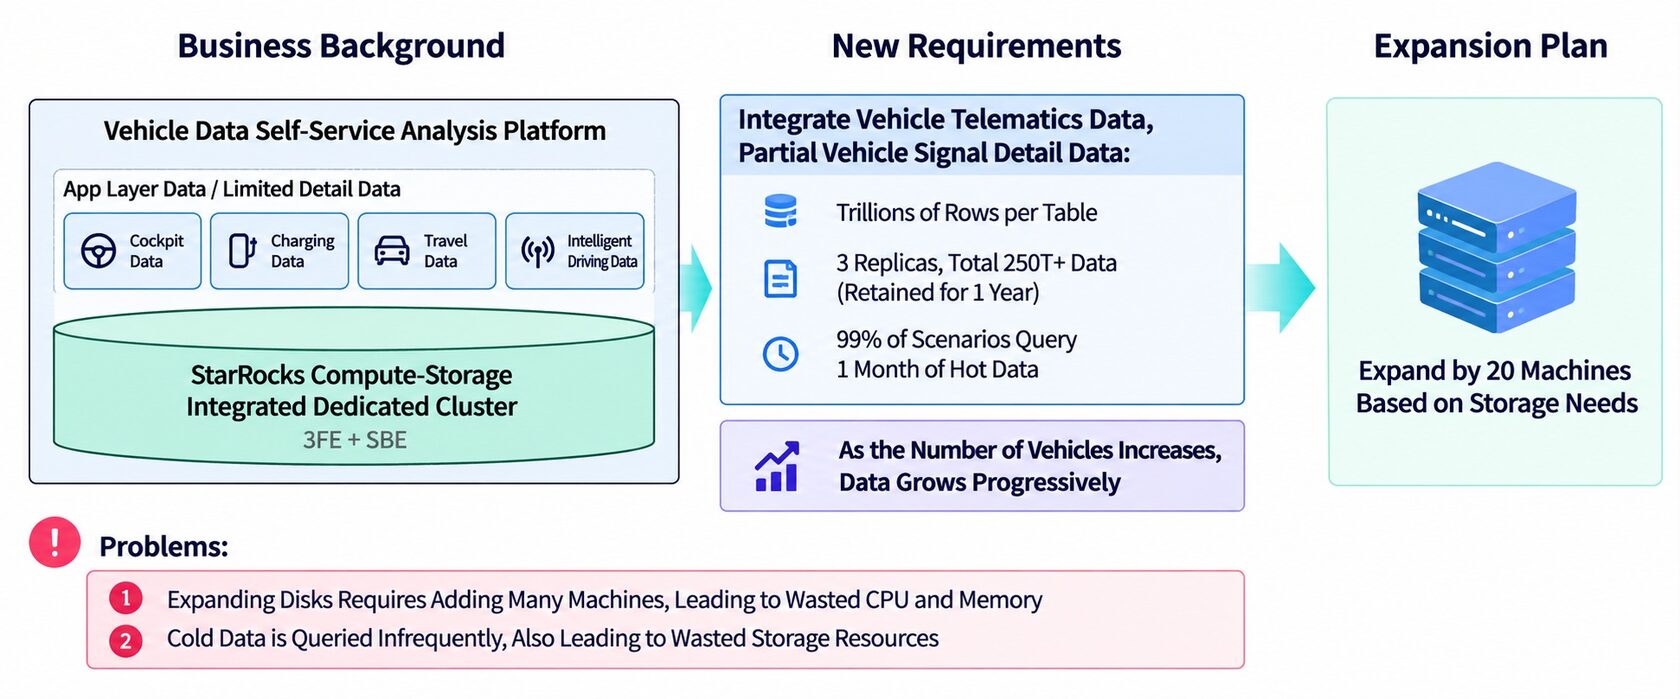
Платформа самообслуживания для анализа данных транспортных средств является критически важной бизнес-системой Li Auto, изначально использовавшейся для анализа данных уровня APP и небольшого объёма детальных данных.
По мере роста бизнеса система должна была интегрировать телематические данные и данные датчиков транспортных средств. Объём данных в одной таблице быстро вырос до триллионов строк, а потребность в хранилище достигла 250 Тб. При интегрированной архитектуре команде приходилось расширять вычислительные ресурсы в соответствии с потребностями хранения.
При таких огромных объёмах данных команда обнаружила, что 99% запросов фокусируются только на самых свежих данных за последний месяц, при этом большие объёмы исторических данных редко используются. Это не только приводило к значительному распылению ресурсов CPU и памяти, но, что более важно, по мере роста количества транспортных средств такая модель расширения становилась всё менее устойчивой.
Проблема 3: Слабая эластичность и низкое потребление ресурсов
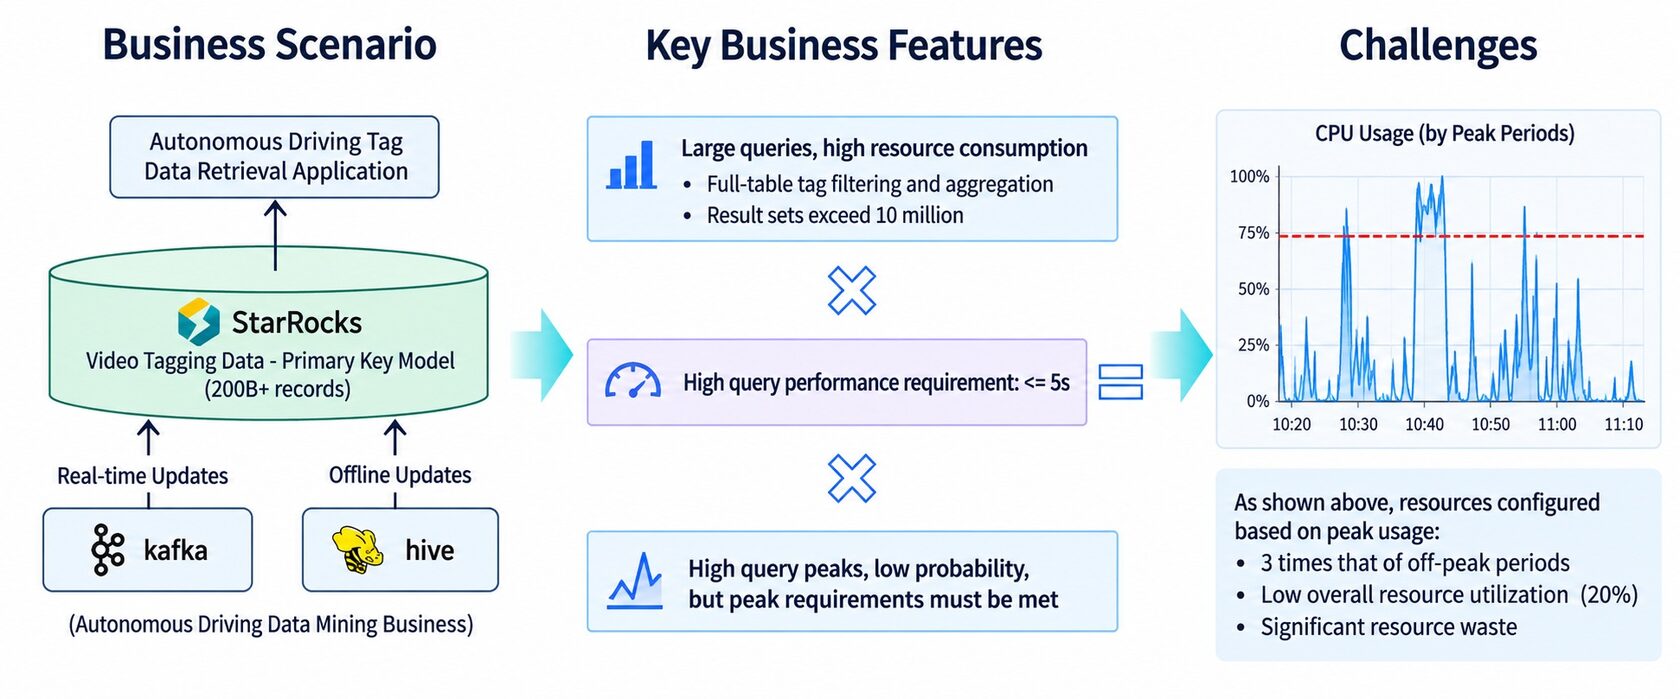
В сценарии анализа данных через машинное обучение команда поддерживала таблицу с первичным ключом, содержащую более 200 млрд записей для извлечения меток данных, используемых при обучении моделей машинного обучения. Запросы в этом сценарии имеют три ключевые характеристики:
- Требуется полное сканирование таблицы и агрегация с фильтрацией
- Размер результирующего набора данных огромный (десятки миллионов)
- Высокие требования к производительности запросов (выполнение за 5 секунд)
Ситуация усложнялась тем, что пики запросов сильно колебались, хотя частота таких пиков была низкой. Чтобы удовлетворить пиковые требования, команде приходилось настраивать ресурсы, исходя из максимальной нагрузки, что приводило к общему потреблению ресурсов всего около 20%.
Эти три проблемы указывали на ключевую проблему: традиционная архитектура shared-nothing не способна удовлетворить растущим требованиям к гибкости, изоляции и экономической эффективности крупномасштабных OLAP-систем, что требует обновления и перестройки системы.
Решение проблем архитектуры shared-data с помощью StarRocks
1. Многокластерная изоляция для решения проблем стабильности
Первый уровень: Изоляция внутренних и внешних таблиц
Команда полностью разделила запросы внешних таблиц Data Lakehouse от операций с внутренними таблицами, предотвратив влияние нестабильных запросов на внутренние операции.
Второй уровень: Изоляция бизнес-сценариев
Внутри кластера Data Lakehouse команда разделила гибкий анализ от традиционных BI-задач. В кластере с внутренними таблицами также была реализована изоляция высокоприоритетных и низкоприоритетных бизнес-задач. Такая вертикальная физическая изоляция оказалась намного эффективнее предыдущего подхода агрегированных ресурсов, обеспечивая стабильную работу приоритетных задач.
Третий уровень: Изоляция нагрузки чтения/записи
Команда выделила задачи с интенсивной записью (включая операции уплотнения) в отдельный кластер. В сочетании с горизонтальной изоляцией агрегированных ресурсов это обеспечило лучшую многомерную изоляцию.
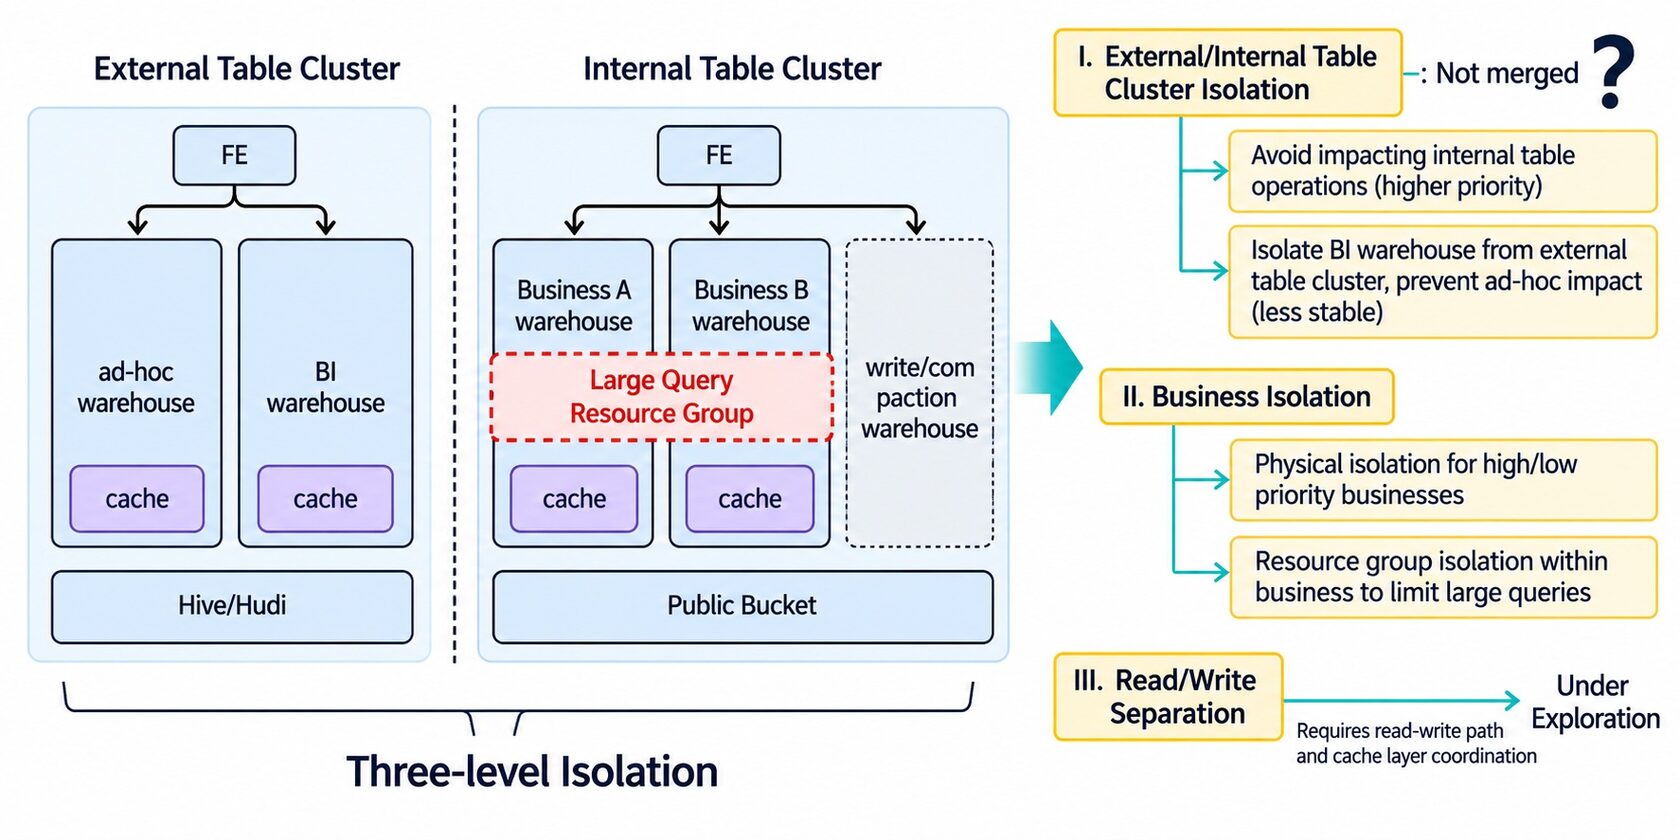
Благодаря вертикальной изоляции через хранилище данных и горизонтальной через агрегирование ресурсов, Li Auto удалось реализовать надёжные механизмы изоляции, значительно повысив стабильность системы.
2. Создание комплексной системы обеспечения стабильности
Предотвращение проблем
Команда создала универсальный механизм проверки для проактивного выявления потенциальных рисков. Используя сервис DQS, был реализован перехват SQL-запросов для фильтрации высокорискованных запросов и были применены инструменты оценки ресурсов для их правильного распределения.
Контроль (во время проблем)
Благодаря многоуровневым возможностям изоляции, команда смогла эффективно минимизировать область воздействия при сбоях, значительно снизив риск каскадных отказов.
Руководство данными (после проблем)
Команда внедрила методологию руководства данными для устранения рисков, связанных с данными и метаданными, регулярно анализировала исторические проблемы для выявления областей оптимизации. Дополнительно команда активно отправляла запросы на исправление по обнаруженным ошибкам в сообщество StarRocks.
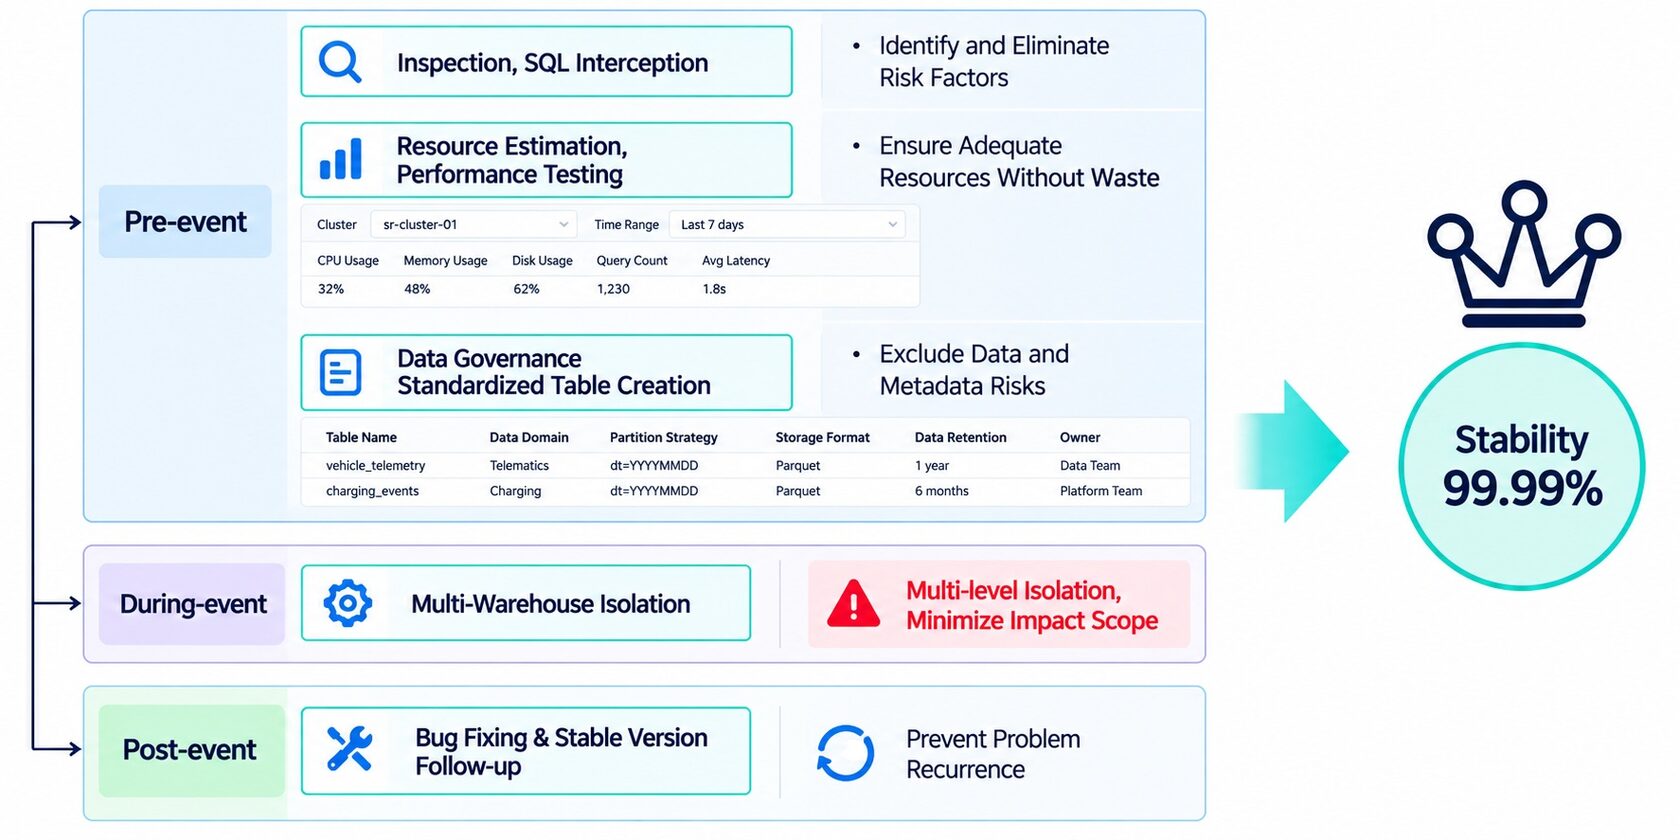
Благодаря этой комплексной системе обеспечения стабильности в сочетании с возможностями множественных хранилищ данных, стабильность платформы Li Auto достигла 99,99%, что стало значительным улучшением по сравнению с предыдущими показателями.
3. Shared-data: решение проблемы отсутствия гибкости при увеличении объемов данных
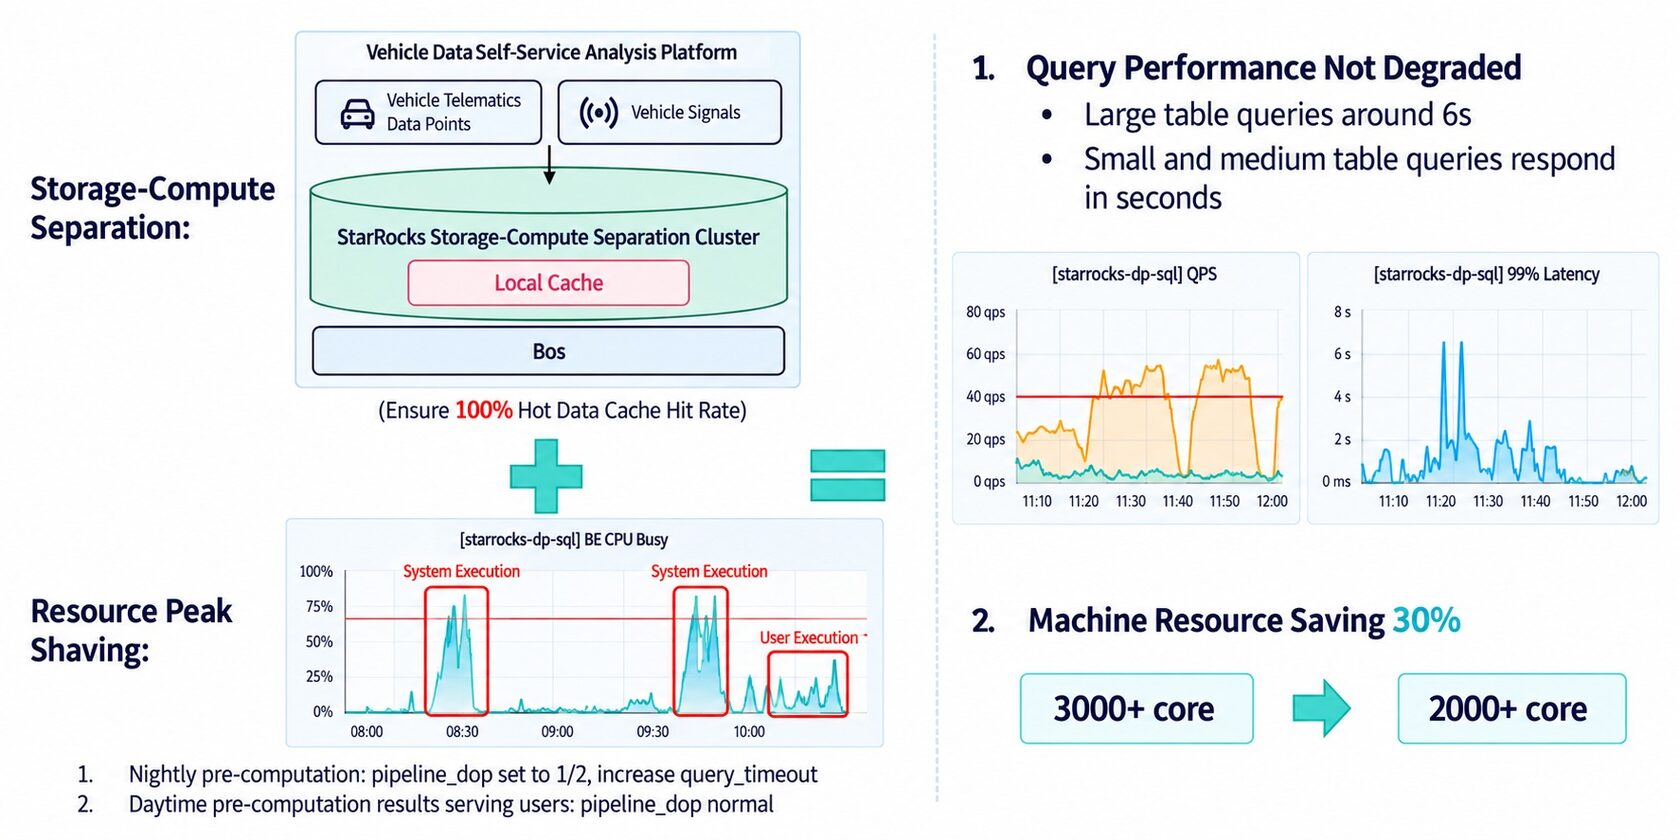
Платформа анализа данных транспортных средств Li Auto стала лучшим доказательством ценности архитектуры shared-data. Столкнувшись с постоянно растущим объёмом данных, команда внедрила новую стратегию хранения: холодные данные хранятся в объектном хранилище, и только «горячие» данные за последний месяц кэшируются на локальных дисках.
Это решение было подтверждено тщательным анализом данных. Команда больших данных Li Auto проанализировала журналы запросов за последние шесть месяцев и обнаружила, что 99% запросов обращаются к данным за последние 30 дней. Благодаря такому подходу к разделению «горячих» и «холодных» данных, команда значительно сократила потребности в локальном хранилище, сохранив при этом производительность запросов.
На бизнес-уровне команда также внедрила меры по сглаживанию пиковых нагрузок. Например, они предварительно вычисляют результаты ночью, уменьшая параллелизм CPU, а затем напрямую запрашивают предварительно вычисленные результаты в течение дня. Эта стратегия позволила поддерживать ночное использование ресурсов на разумном уровне, оставляя достаточно мощности для пиковых дневных запросов.
Благодаря этим мерам команда сэкономила 30% машинных ресурсов без ущерба для производительности запросов. Это не только решило текущие проблемы, но и предоставило устойчивое решение для будущего роста данных.
4. StarRocks на K8s: Достижение эластичной масштабируемости
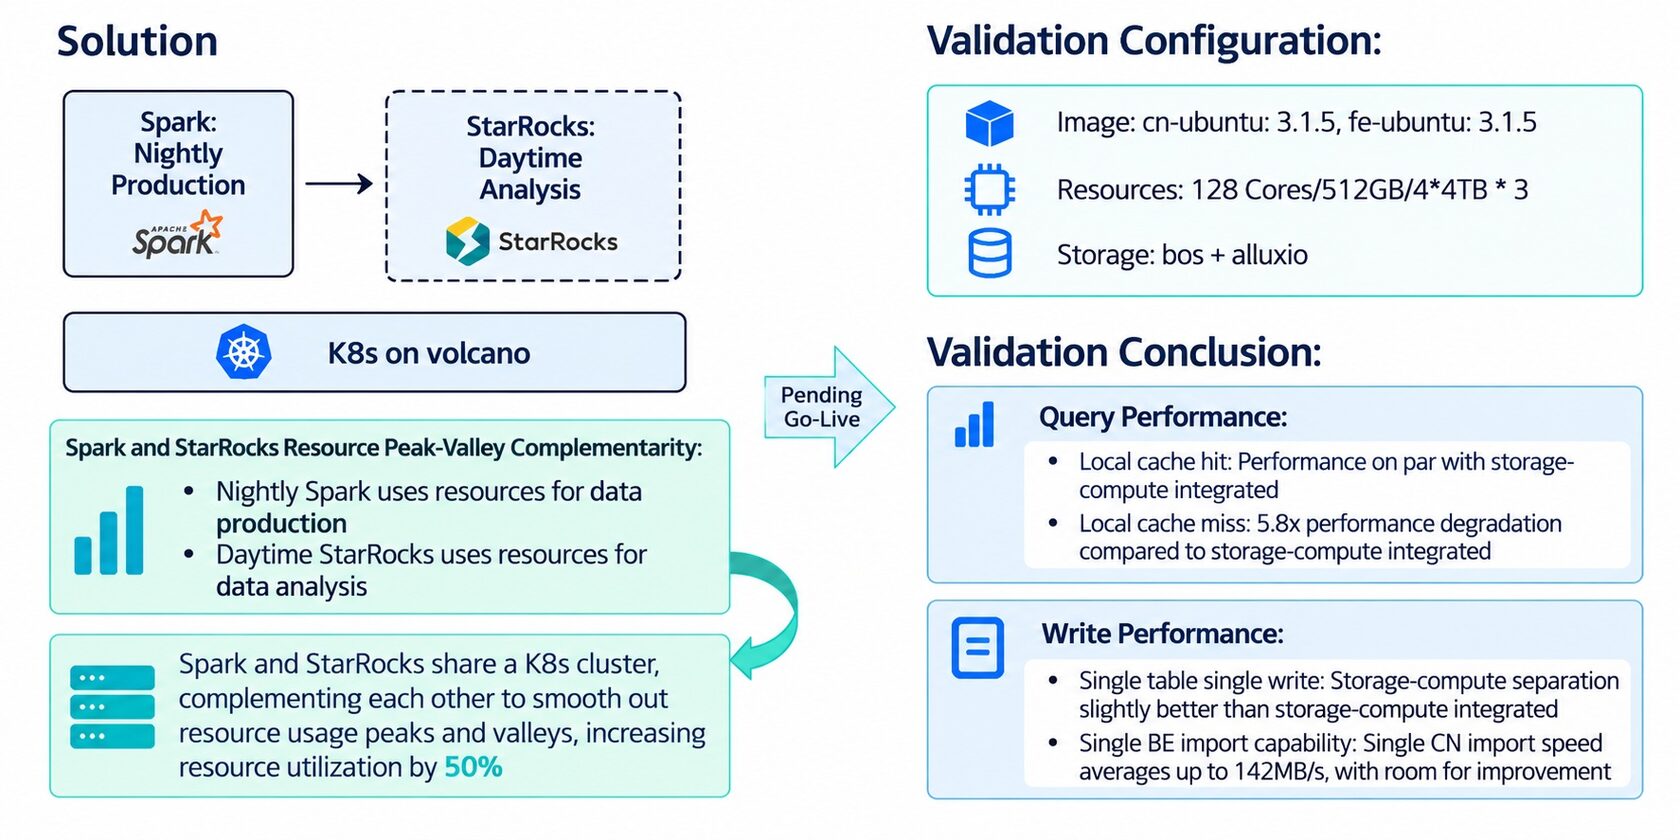
Команда больших данных Li Auto заметила взаимодополняющие пики и спады между OLAP-запросами и производственными задачами Spark. В течение дня наблюдаются пиковые значения OLAP-запросов, в то время как Spark-задачи менее часты, а ночью ситуация меняется на противоположную.
Основываясь на этом, команда использовала характеристики взаимодополняющей нагрузки обеих задач: в течение дня StarRocks использует ресурсы для анализа данных, а ночью Spark использует ресурсы для генерации данных. Такое динамическое распределение ресурсов между StarRocks и Spark, корректируемое в течение дня, обеспечило необходимую эластичную масштабируемость.
Результаты проверки показали, что при попадании данных в локальный кэш, производительность запросов была на уровне shared-nothing. Даже при отсутствии попадания в кэш снижение производительности оставалось в приемлемом диапазоне после оптимизации параметров.
Кроме того, команда обнаружила, что производительность записи для отдельных таблиц стала фактически лучше, чем в предыдущей архитектуре. Возможности импорта каждого узла CN/BE достигали 142 Мб/с. С помощью этого решения ожидается увеличение общего использования ресурсов на 50%.
5. Замена Spark на StarRocks для ускорения обработки запросов «на лету» в Data Lakehouse
Помимо решения основных архитектурных проблем, команда Li Auto также использовала StarRocks для решения проблемы эффективности с запросами «на лету» в Data Lakehouse.
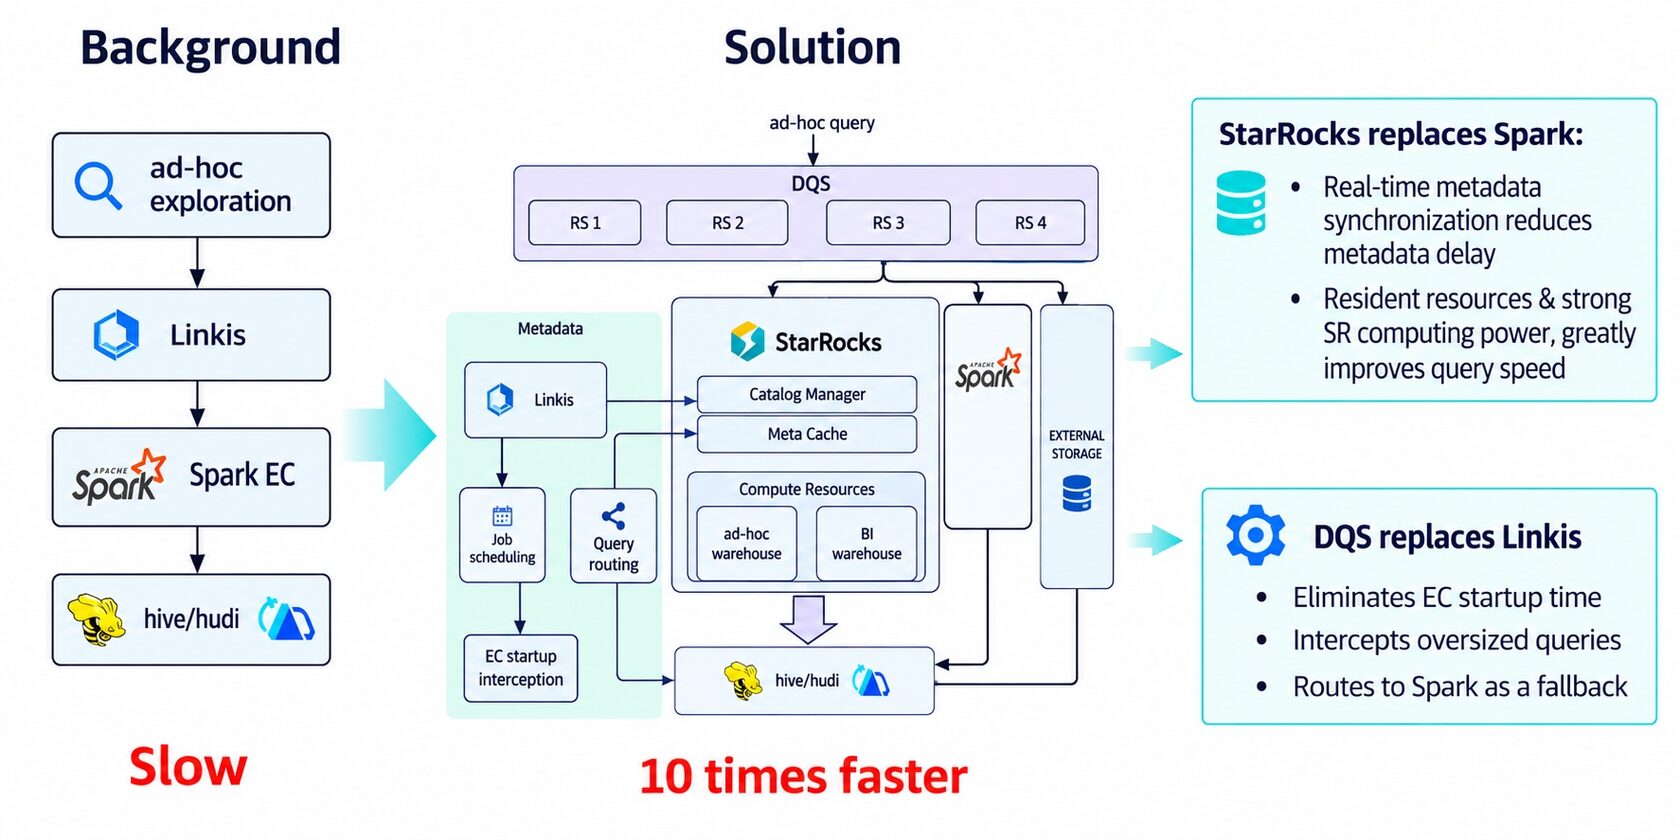
В традиционной архитектуре эти типы запросов опирались на комбинацию Linkis + Spark. Даже простые запросы обрабатывались десятки секунд, что приводило к неудовлетворённости пользователей.
Команда разработала новое решение для ускорения запросов:
Это решение улучшило производительность обработки запросов «на лету» в 10 раз, не только повысив эффективность работы аналитиков данных, но и обеспечив более своевременную поддержку принятия бизнес-решений.
Команда разработала новое решение для ускорения запросов:
- Flink использовался для синхронизации метаданных Metastore в режиме реального времени с StarRocks, устраняя задержки при получении метаданных
- Возможности по экономии ресурсов StarRocks использовались для избежания накладных расходов на выделение ресурсов для каждого запроса
- Команда также интегрировала самостоятельно разработанный сервис DQS для замены Linkis, упрощая план запросов и повышая стабильность
Это решение улучшило производительность обработки запросов «на лету» в 10 раз, не только повысив эффективность работы аналитиков данных, но и обеспечив более своевременную поддержку принятия бизнес-решений.
План на будущее: полностью облачная архитектура
Благодаря успешному применению StarRocks в Li Auto, команда уже начала планировать следующий этап эволюции архитектуры, направленный на создание полностью облачной OLAP-платформы.
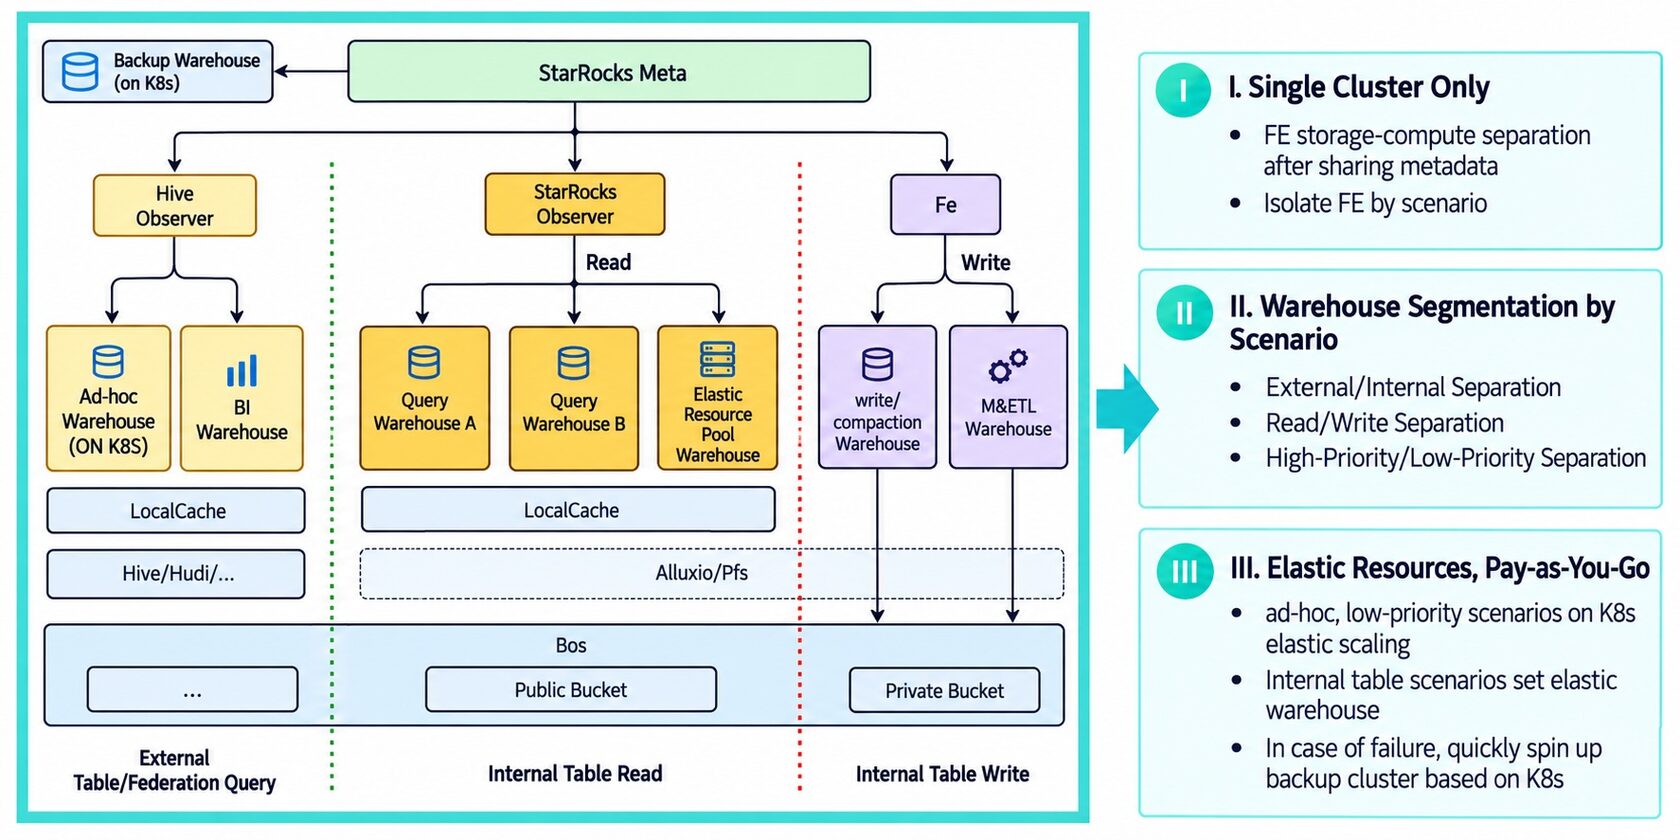
Основная цель команды – достижение полностью разделённой архитектуры хранения и вычислений. В настоящее время разделение фокусируется на вычислительных узлах, в то время как служба метаданных всё ещё использует интегрированную модель хранения и вычислений. Будущий план заключается в объединении всех кластеров в один кластер с общим доступом к метаданным для предотвращения разрозненности данных.
Команда планирует разделить архитектуру хранилищ данных на основе сценариев. В рамках одного кластера команда будет реализовывать разделение внутренних и внешних таблиц и гибко разделять хранилища на основе приоритетов бизнеса и типов нагрузки, обеспечивая смешанное управление внутренними и внешними таблицами и унифицированный доступ к метаданным.
Что касается эластичности ресурсов и оптимизации затрат, команда планирует размещать задачи с низким приоритетом в среде K8s для достижения эластичного масштабирования, в то время как сценарии с высокими требованиями к производительности будут развернуты на физических серверах или облачных хостах. Кроме того, команда разрабатывает механизм для поддержки динамического балансирования нагрузки между хранилищами данных для дальнейшего повышения эффективности использования ресурсов.
Благодаря этой серии эволюций облачной архитектуры, Li Auto и StarRocks совместно создали модернизированную OLAP-платформу, сочетающую в себе стабильность, эластичность и экономическую эффективность. Эта платформа не только эффективно поддерживает весь спектр потребностей от интеллектуального анализа транспортных средств до принятия бизнес-решений, но, что более важно, закладывает прочную основу для трансформации компании, основанной на датацентричности, делая данные ключевым драйвером бизнес-инноваций.