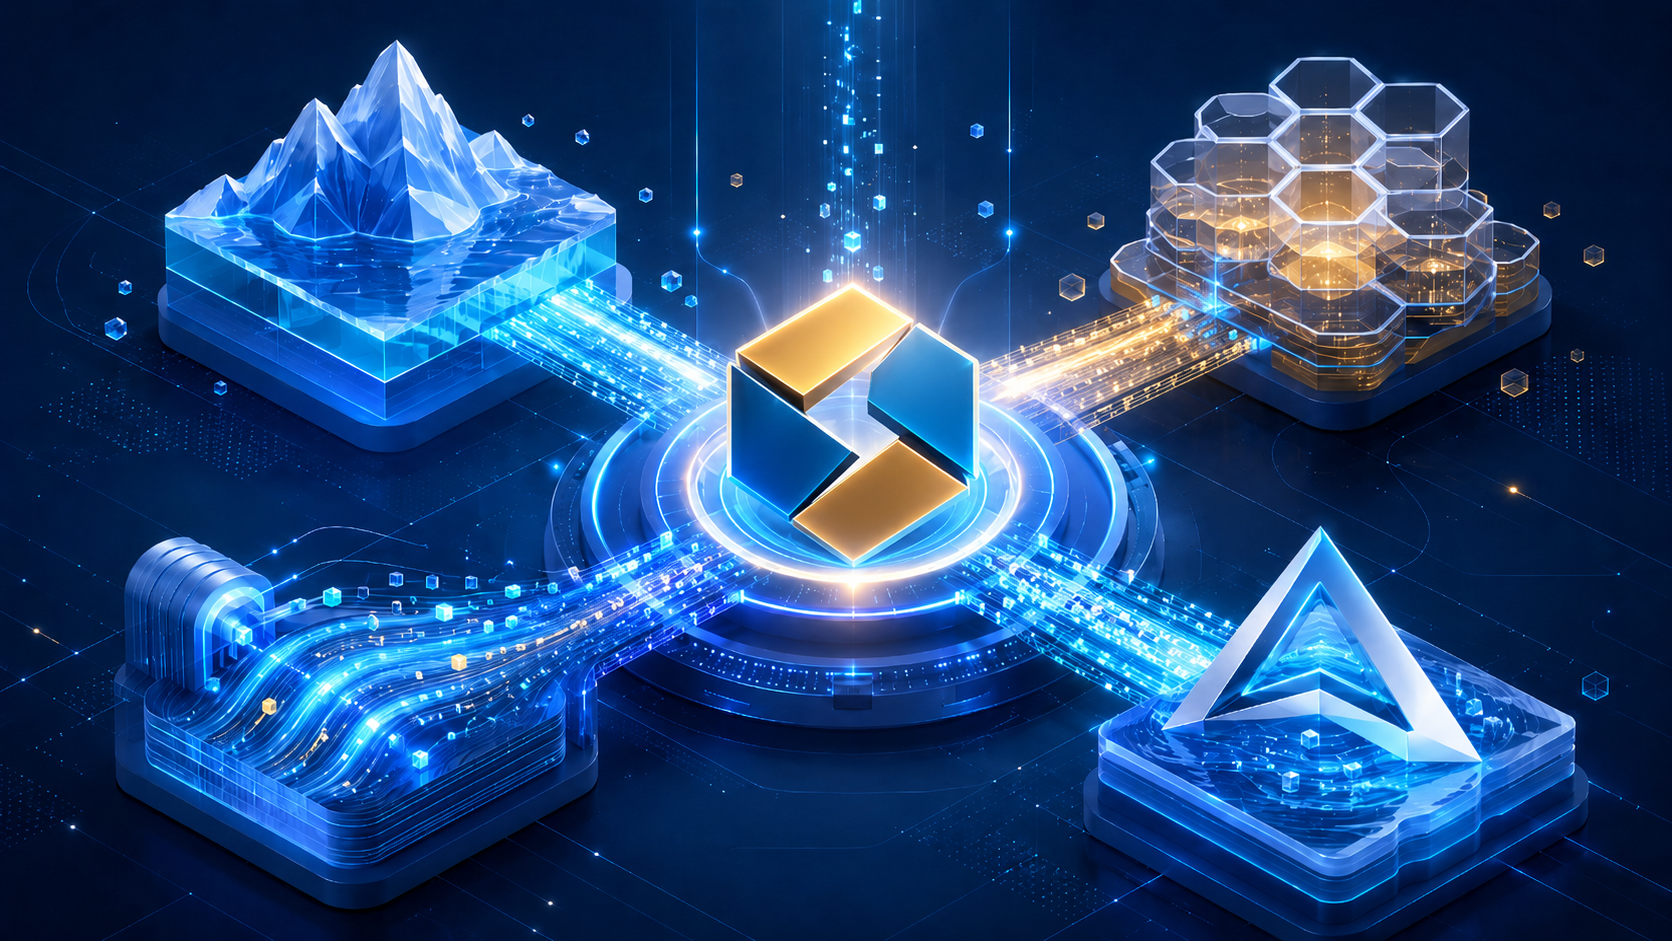
Современные аналитические платформы всё чаще отказываются от монолитных хранилищ в пользу Lakehouse-архитектуры - подхода, при котором данные хранятся в открытых форматах в озёрах данных (Data Lake), а различные движки запросов работают с ними напрямую.
StarRocks - один из лидеров в этой области, предоставляя возможность анализировать данные из Hive, Iceberg, Delta Lake, Hudi и других источников без миграции и копирования.
StarRocks - один из лидеров в этой области, предоставляя возможность анализировать данные из Hive, Iceberg, Delta Lake, Hudi и других источников без миграции и копирования.
StarRocks - один из лидеров в этой области, предоставляя возможность анализировать данные из Hive, Iceberg, Delta Lake, Hudi и других источников без миграции и копирования.
В этой статье мы разберём, какие открытые форматы данных поддерживает StarRocks, в каких сценариях каждый из них лучше использовать, и в чём заключаются их ключевые преимущества.
Архитектура внешних каталогов
StarRocks предлагает единый механизм для работы с внешними данными - External Catalog (внешний каталог). Это прослойка, которая подключается к метаданным внешнего источника (например, Hive Metastore или AWS Glue) и позволяет выполнять SQL-запросы к данным так, как если бы они хранились внутри StarRocks.
Начиная с версии 3.2, StarRocks также поддерживает Unified Catalog - специальный тип внешнего каталога, который объединяет Hive, Iceberg, Hudi и Delta Lake в единый источник данных. Это особенно удобно, если в вашей организации одновременно используются разные форматы таблиц.
Ключевая философия: данные не нужно импортировать - StarRocks читает их «на лету» из объектного хранилища (S3, OSS, GCS, MinIO) или HDFS. Это даёт единый источник данных для BI, AI, ad-hoc-запросов и отчётов.
Hive Metastore - классика для больших данных
Hive - это не столько формат хранения, сколько метасервис (Hive Metastore, HMS), который хранит информацию о таблицах, их схемах, разделах и расположении файлов. Самые данные при этом могут быть в Parquet, ORC, Textfile, Avro, RCFile или SequenceFile.
Когда использовать Hive?
- Наследие: если у вас уже есть большое хранилище на Hive, и вы не хотите его мигрировать
- Простота: Hive Metastore - де-факто стандарт в экосистеме Hadoop, поддерживается практически всеми движками (Spark, Presto, Trino)
- Широкая поддержка форматов: Hive-таблицы могут храниться в любых файловых форматах, включая Textfile и Avro
Выгоды использования Hive Catalog в StarRocks:
- Поддержка с v2.4 - зрелая и проверенная интеграция
- Запись данных обратно в Hive - с помощью INSERT INTO можно не только читать, но и записывать результаты в Parquet (с v3.2), ORC и Textfile (с v3.3) Hive-таблицы
- Создание и удаление Hive-таблиц прямо из StarRocks
- Поддерживается широкий спектр сжатий: SNAPPY, LZ4, ZSTD, GZIP, LZO
Ограничения:
- StarRocks не поддерживает типы данных Hive: INTERVAL, BINARY, UNION, а также MAP и STRUCT для Textfile-таблиц
Apache Iceberg – современный табличный формат
Apache Iceberg - это табличный формат (table format), который добавляет к данным уровень абстракции: поддержку ACID-транзакций, снимков (snapshots), эволюцию схемы, скрытое партиционирование и многое другое.
Когда использовать Iceberg?
- Требуется ACID: если вам нужны гарантии атомарности, согласованности, изоляции и долговечности при записи данных.
- Time Travel: необходимо анализировать состояние таблицы на любой момент времени.
- Сложное управление данными: ветвление (branching) и тегирование (tagging) снимков для разных стратегий хранения.
- Массивные таблицы с тысячами партиций: Iceberg эффективно управляет метаданными даже при очень большом количестве файлов.
Выгоды использования Iceberg Catalog в StarRocks:
- Поддержка с v2.4; чтение и запись в Iceberg-таблицы
- Поддержка двух версий таблиц: v1 и v2 (с поддержкой позиционных и равенственных удалений в зависимости от версии)
- Поддержка двух форматов файлов: Parquet и ORC с множеством алгоритмов сжатия
- Iceberg Metadata Tables (с v3.4.1) - можно запросить историю изменений, снапшоты и манифесты прямо через SQL
- Time Travel-запросы - доступ к историческим версиям данных
- Создание Iceberg-таблиц и запись данных из StarRocks
Производительность:
StarRocks показывает производительность, близкую к локальному диску, даже при работе с Iceberg на S3-совместимых хранилищах.
Delta Lake – озеро с ACID от Databricks
Delta Lake – это открытый формат таблиц, разработанный Databricks. Он обеспечивает ACID-транзакции поверх Parquet-файлов, поддерживает потоковую и пакетную обработку, а также эволюцию схемы.
Когда использовать Delta Lake?
- Экосистема Databricks/Spark: если ваши ETL-пайплайны строятся на Spark с использованием Delta Lake
- Потоковая + пакетная обработка: Delta Lake унифицирует оба подхода
- ACID-гарантии: аналогично Iceberg, но с более тесной интеграцией со Spark
Выгоды использования Delta Lake Catalog в StarRocks:
- Поддержка с v2.5
- Parquet - единственный поддерживаемый формат файлов (с алгоритмами сжатия SNAPPY, LZ4, ZSTD, GZIP, NO_COMPRESSION)
- Хранилища: HDFS, AWS S3, Microsoft Azure Storage, Google GCS, MinIO
- Метасторы: Hive Metastore или AWS Glue
Ограничения:
- Не поддерживаются сложные типы данных Delta Lake: MAP и STRUCT
Unified Catalog: все форматы в одном флаконе
Если в вашей организации одновременно используются Hive, Iceberg и Delta Lake, StarRocks предлагает Unified Catalog (с v3.2). Он позволяет подключить все эти источники как единый каталог при условии, что они используют одну и ту же систему хранения и одно мета-хранилище.
Возможности Unified Catalog:
- Прямые запросы без создания таблиц в StarRocks
- Загрузка данных через INSERT INTO или асинхронные материализованные представления
- Создание и удаление Hive и Iceberg таблиц
Важно: операции, специфичные для формата, поддерживаются только для соответствующих таблиц. Например, CREATE TABLE - только для Hive и Iceberg, а REFRESH EXTERNAL TABLE - для Hive и Hudi.
Какой формат выбрать
Преимущества работы с открытыми форматами в StarRocks
- Отсутствие привязки к вендору (No Lock-in) - можно сменить движок запросов в любой момент.
- Экономия на ETL - не нужно копировать данные в отдельное хранилище; аналитика выполняется прямо в озере данных.
- Единый источник истины - одни и те же данные доступны для BI, AI, ad-hoc и отчётности.
- Высокая производительность - векторизованный движок StarRocks и CBO (Cost-Based Optimizer) обеспечивают высокую скорость даже при работе с внешними данными.
- JOIN между разными форматами - можно соединять таблицы из Iceberg, Hudi и Hive в одном запросе.
- Гибкая масштабируемость - вычисления (StarRocks) и хранение (Data Lake) масштабируются независимо.
Практические рекомендации
- Для новых проектов с высокими требованиями к ACID и управлению данными выбирайте Iceberg
- Если вы уже используете Databricks или Spark с потоковой обработкой - Delta Lake будет естественным выбором
- Для существующих Hive-хранилищ без потребности в ACID - Hive Catalog даст быстрый и простой доступ
- При смешанном ландшафте используйте Unified Catalog для унификации доступа
- Старайтесь избегать использования внешних таблиц (external tables) - в StarRocks они считаются устаревшими; вместо них рекомендуется External Catalog
Заключение
StarRocks предоставляет зрелый и производительный механизм для работы с открытыми форматами данных через External Catalog. Благодаря поддержке Hive, Iceberg и Delta Lake, а также Unified Catalog, StarRocks становится идеальным аналитическим движком для Lakehouse-архитектуры. Выбор конкретного формата зависит от ваших текущих инвестиций в инфраструктуру, требований к ACID и инструментов, которые вы используете для ETL. Но в любом случае StarRocks позволяет вам анализировать данные там, где они лежат, без лишних копирований и миграций.